Wie aus >100.000 Kundenservice-Tickets zwei nutzbare FAQ‑Sammlungen wurden
In meinem Restrukturierungsmandat bei einem Fintech in Braunschweig stand ein kurzfristiger Hebel im Fokus: den Kundenservice entlasten und Kosten senken. Statt Redaktionssprints habe ich einen ETL‑Workflow in n8n gebaut, der aus echten Supportfällen zwei FAQ‑Korpora erzeugt – für Kreditoren und Debitoren. Zunächst erschienen die Inhalte als Hilfesnippets direkt in Zendesk‑Tickets; im zweiten Schritt dienen sie als Wissensbasis für einen First‑Level‑Servicebot (Text & Sprache).
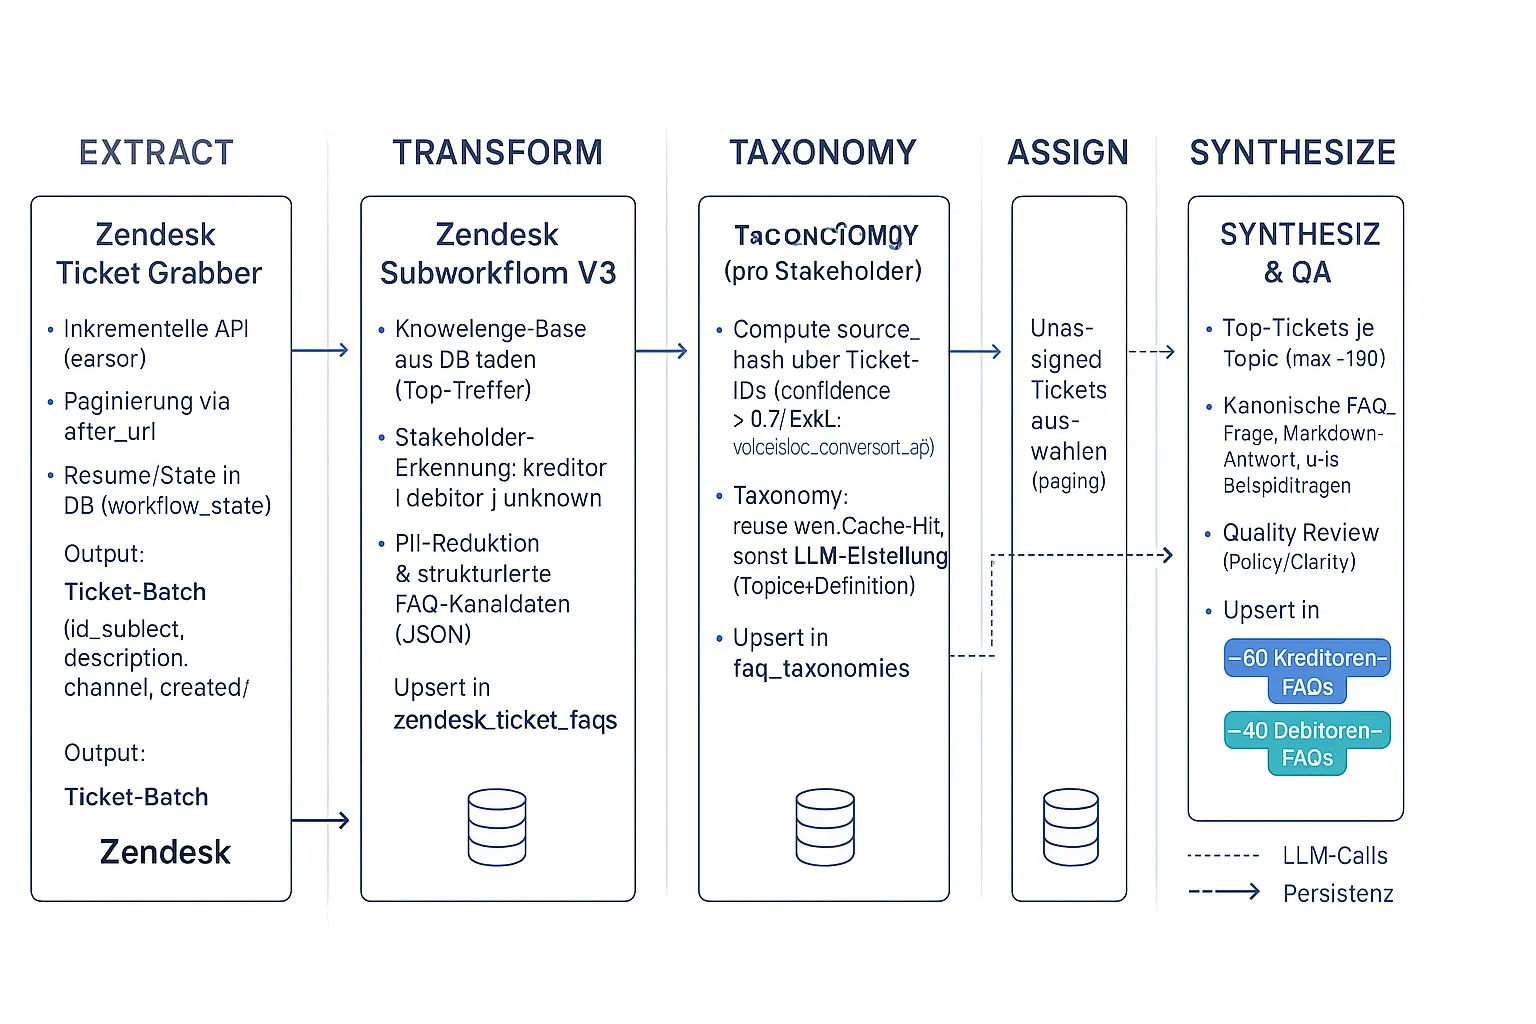
Schritt 1: Datenzugang robust machen
Ein „Ticket Grabber“ lädt sämtliche Tickets über die Zendesk Cursor‑API inkrementell, speichert den Laufzustand (Cursor, Fortschritt, Status) in Postgres/Supabase und kann jeden Run nach Abbruch sauber fortsetzen. Pro Seite werden die Tickets an einen Subworkflow gestreamt. Das minimiert Timeouts und macht den Prozess wiederaufsetzbar – entscheidend bei sechsstelligen Ticketvolumina.
Schritt 2: Aus Tickets strukturierte Q&As gewinnen
Der Subworkflow filtert irrelevante Kanäle (z. B. Voice/Side Conversations), lädt die Kommentar‑Historie und lässt ein LLM aus der Konversation eine präzise Frage‑Antwort‑Einheit extrahieren – inklusive Stakeholder‑Einschätzung (Kreditor/Debitor), Confidence und optionalen KB‑Referenzen. Jede Einheit wird als Datensatz zendesk_ticket_faqs persistiert (Upsert), Errors werden getrennt geloggt. So entsteht schnell eine breite, deduplizierbare Lösungsbasis.
Schritt 3: Themenlandkarte automatisch aufbauen
Für jeden Stakeholder erzeuge ich aus einem repräsentativen Sample (ca. 750 Tickets bei Kreditoren, 500 bei Debitoren) eine Taxonomie aus Topics. Diese Taxonomie wird versioniert gecacht (Source‑Hash), danach ordnet ein Klassifizierer jedes Ticket genau einem Topic zu und schreibt das Mapping mit Confidence nach topic_assignments. Ein Coverage‑Report zeigt sofort, wie gut die Themen die Ticketlandschaft abdecken.
Schritt 4: Kanonische FAQs je Topic synthetisieren
Je Topic ziehe ich die besten 100–150 Q&A‑Beispiele, promptete ein LLM, eine kanonische Frage plus prägnante Markdown‑Antwort und 3–5 Beispielfragen zu erzeugen. Eine zweite LLM‑Schleife prüft Qualität/Compliance und schlägt bei Bedarf eine Umschreibung vor. Das Ergebnis landet als Datensatz faqs (inkl. canonical_answer_md) und wird je Stakeholder als Markdown konsolidiert – die zwei Dateien, die wir anschließend als Snippets in Zendesk eingesetzt haben.
Praktischer Effekt & Governance
Vor dem Live‑Einsatz haben zwei Mitarbeitende einmal Korrektur gelesen – mehr war nicht nötig, weil die Inhalte empirisch aus vielen gleichartigen Fällen entstanden. Tatsächlich kamen so rund 60 umfangreiche Kreditoren‑FAQs und 40 Debitoren‑FAQs zusammen, deutlich vollständiger, als es eine Redaktion in gleicher Zeit hätte leisten können.
Warum das wirkt
Vollständigkeit durch Breite: Die FAQs basieren auf einer großen Zahl realer Lösungen statt Einzelmeinungen.
Skalierbarkeit & Wiederverwendbarkeit: Der Pipeline‑Charakter (robuste Ingestion, strukturierte Q&As, automatische Themenbildung, kanonische Synthese) erlaubt schnelle Re‑Runs bei neuen Daten.
Kosten- und Zeiteffekt: Direkter Entlastungshebel im Service durch Snippets – und zugleich die Grundlage für einen Bot, der First‑Level‑Anliegen automatisiert übernimmt.
Kurz: Ein datengetriebener, wiederholbarer Weg, in einer Restrukturierung schnell Wirkung im Kundenservice zu erzielen – mit messbarer Qualität und geringem Redaktionsaufwand.
Mehr dazu, wie ich KI in der Steuerung einsetze, steht auf meiner persönlichen Seite. Über mich